Sie bauen Ihren eigenen Agenten für die Incident-Behebung?

Sie bauen Ihren eigenen Agenten für die Incident-Behebung?

Sie bauen Ihren eigenen Agenten für die Incident-Behebung?

Painterly illustration of an eagle soaring above a mountain range at sunset

Selbst gehosteter IT-Ops-Agent

KI für Prod, die in der Infrastruktur bleibt.

Incidents beheben, manuelle Routinearbeit reduzieren, Betriebswissen zentral bündeln.

Painterly illustration of sunrise over snow-capped mountain peaks

Selbst gehosteter IT-Ops-Agent

KI für Prod, die in der Infrastruktur bleibt.

Incidents beheben, manuelle Routinearbeit reduzieren, Betriebswissen zentral bündeln.

Painterly illustration of sunrise over snow-capped mountain peaks

Selbst gehosteter IT-Ops-Agent

KI für Prod, die in der Infrastruktur bleibt.

Incidents beheben, manuelle Routinearbeit reduzieren, Betriebswissen zentral bündeln.

Logo der Deutschen Bahn
Logo von Toom Baumarkt
Logo von IFM
Logo von TRATON
MAN Logo
Logo von easybell
Logo von MaibornWolff
Logo von Adesso
Logo von Giant Swarm
Logo von Automated Ops
Logo der Deutschen Bahn
Logo von Toom Baumarkt
Logo von IFM
Logo von TRATON
MAN Logo
Logo von easybell
Logo von MaibornWolff
Logo von Adesso
Logo von Giant Swarm
Logo von Automated Ops

So funktioniert's

Eine Intelligenzschicht über dem gesamten System

Alerts werden untersucht, in dem Moment, in dem sie ausgelöst werden. Die Untersuchung liefert wahrscheinliche Ursachen, Belege und den nächsten Schritt. Manuelle Arbeiten, die sich wiederholen, werden zu einem Skill, der nach Zeitplan läuft.

Benutzeroberfläche zum Anlegen einer Aufgabe

Kundenstimmen

Führende europäische Unternehmen vertrauen Hyground.

  • Nach einem erfolgreichen Proof of Concept setzt der Bereich Reisendeninformation der Deutschen Bahn Hyground nun regelmäßig ein und steigert damit Effizienz und Stabilität seiner IT-Systeme

    Logo der Deutschen Bahn
    Deutsche Bahn

    Site Reliability Engineer

    Nach einem erfolgreichen Proof of Concept setzt der Bereich Reisendeninformation der Deutschen Bahn Hyground nun regelmäßig ein und steigert damit Effizienz und Stabilität seiner IT-Systeme

    Logo der Deutschen Bahn
    Deutsche Bahn

    Deutsche Bahn

    Nach einem erfolgreichen Proof of Concept setzt der Bereich Reisendeninformation der Deutschen Bahn Hyground nun regelmäßig ein und steigert damit Effizienz und Stabilität seiner IT-Systeme

    Logo der Deutschen Bahn
    Deutsche Bahn

    Site Reliability Engineer

    Hyground hilft uns, alle internen Cluster reibungslos zu betreiben, und schafft unseren Engineers wertvolle Zeit

    Logo von MaibornWolff
    Jakob Tewes

    Head of IT

    Hyground hilft uns, alle internen Cluster reibungslos zu betreiben, und schafft unseren Engineers wertvolle Zeit

    Logo von MaibornWolff
    Jakob Tewes

    Maiborn Wolff

    Hyground hilft uns, alle internen Cluster reibungslos zu betreiben, und schafft unseren Engineers wertvolle Zeit

    Logo von MaibornWolff
    Jakob Tewes

    Head of IT

    Die Zusammenarbeit mit dem Hyground-Team bestätigt: Die Technologie ist nicht nur stark, sondern genau das, worauf der Markt gewartet hat

    Wladimir Jerschow

    Principal IT Architect

    Die Zusammenarbeit mit dem Hyground-Team bestätigt: Die Technologie ist nicht nur stark, sondern genau das, worauf der Markt gewartet hat

    Wladimir Jerschow

    SoITing

    Die Zusammenarbeit mit dem Hyground-Team bestätigt: Die Technologie ist nicht nur stark, sondern genau das, worauf der Markt gewartet hat

    Wladimir Jerschow

    Principal IT Architect

    Die gemeinsame Innovationsarbeit mit Hyground verläuft konstruktiv. Fachliche Tiefe und Tempo machen die Zusammenarbeit unkompliziert

    Logo von Giant Swarm
    Timo Derstappen

    CTO

    Die gemeinsame Innovationsarbeit mit Hyground verläuft konstruktiv. Fachliche Tiefe und Tempo machen die Zusammenarbeit unkompliziert

    Logo von Giant Swarm
    Timo Derstappen

    Giant Swarm

    Die gemeinsame Innovationsarbeit mit Hyground verläuft konstruktiv. Fachliche Tiefe und Tempo machen die Zusammenarbeit unkompliziert

    Logo von Giant Swarm
    Timo Derstappen

    CTO

    Hyground ermöglicht es uns, die Infrastruktur zu skalieren, ohne Personal aufzubauen, indem wiederkehrende SRE-Arbeit über die Incident-Behebung hinaus automatisiert wird

    Logo von IFM
    IFM

    Head of IT Operations

    Hyground ermöglicht es uns, die Infrastruktur zu skalieren, ohne Personal aufzubauen, indem wiederkehrende SRE-Arbeit über die Incident-Behebung hinaus automatisiert wird

    Logo von IFM
    IFM

    IFM

    Hyground ermöglicht es uns, die Infrastruktur zu skalieren, ohne Personal aufzubauen, indem wiederkehrende SRE-Arbeit über die Incident-Behebung hinaus automatisiert wird

    Logo von IFM
    IFM

    Head of IT Operations

AUTO-RCA

Bevor Sie den Laptop aufklappen, ist die Untersuchung abgeschlossen.

Um 03:12 Uhr löst ein Alert aus. Das findet der On-Call-Engineer sechs Minuten später vor.

Hyground eröffnet eine Untersuchung aus dem eingehenden Alert

Der Alert bringt die Vorarbeit gleich mit

Das Monitoring löst per Webhook einen Alert aus. Derselbe Webhook eröffnet zugleich eine Untersuchung. Hyground liest Logs, Metriken, Deployment-Historie und Runbooks, während das Telefon noch vibriert.

03:17 Uhr

Laptop auf, Briefing liegt bereit

03:20 Uhr

Die Entscheidung treffen Sie

Orange mosaic

03:12 Uhr

Der Alert bringt die Vorarbeit gleich mit

Das Monitoring löst per Webhook einen Alert aus. Derselbe Webhook eröffnet zugleich eine Untersuchung. Hyground liest Logs, Metriken, Deployment-Historie und Runbooks, während das Telefon noch vibriert.

Orange mosaic

03:12 Uhr

Der Alert bringt die Vorarbeit gleich mit

Das Monitoring löst per Webhook einen Alert aus. Derselbe Webhook eröffnet zugleich eine Untersuchung. Hyground liest Logs, Metriken, Deployment-Historie und Runbooks, während das Telefon noch vibriert.

Orange mosaic

03:18 Uhr

Laptop auf, Briefing liegt bereit

Im Slack-Thread stehen bereits drei wahrscheinliche Ursachen, nach Konfidenz sortiert. Jede verweist auf die Logzeilen, die Metrikkurve und das Deployment dahinter.

03:18 Uhr

Laptop auf, Briefing liegt bereit

Im Slack-Thread stehen bereits drei wahrscheinliche Ursachen, nach Konfidenz sortiert. Jede verweist auf die Logzeilen, die Metrikkurve und das Deployment dahinter.

03:18 Uhr

Laptop auf, Briefing liegt bereit

Im Slack-Thread stehen bereits drei wahrscheinliche Ursachen, nach Konfidenz sortiert. Jede verweist auf die Logzeilen, die Metrikkurve und das Deployment dahinter.

Orange mosaic

03:20 Uhr

Die Entscheidung treffen Sie

Die oberste Ursache bestätigen oder verwerfen, in derselben Session nachfragen, den Fix selbst anwenden. Jede Änderung in der Produktion bleibt eine menschliche Entscheidung, und jeder Schritt der Untersuchung wird protokolliert.

03:20 Uhr

Die Entscheidung treffen Sie

Die oberste Ursache bestätigen oder verwerfen, in derselben Session nachfragen, den Fix selbst anwenden. Jede Änderung in der Produktion bleibt eine menschliche Entscheidung, und jeder Schritt der Untersuchung wird protokolliert.

03:20 Uhr

Die Entscheidung treffen Sie

Die oberste Ursache bestätigen oder verwerfen, in derselben Session nachfragen, den Fix selbst anwenden. Jede Änderung in der Produktion bleibt eine menschliche Entscheidung, und jeder Schritt der Untersuchung wird protokolliert.

DIE GESAMTE INFRASTRUKTUR BEFRAGEN

Das Wissen der erfahrensten Engineers steht dem ganzen Team offen.

"Warum ist der Checkout langsam?" Diese Frage genügt. Die Antwort steht selten allein in Logs und Metriken. Hyground liest deshalb Traces, Cloud-Accounts, Datenbanken, Tickets, Code und Runbooks in einem Durchlauf und durchsucht dabei jeden betriebenen Cluster.

Cloud

Read

Cloud-Plattformen

Amazon Web Services logo

Amazon Web Services

Vollständige CLI · IAM-geprüft

Microsoft Azure logo

Microsoft Azure

Vollständige CLI · Rolle geprüft

Google Cloud logo

Google Cloud

Vollständige CLI · GKE · Vertex AI

Delivery

Read

GitOps

Argo CD logo

Argo CD

Apps · Sync-Status · Health

Flux CD logo

Flux CD

Kustomizations · Sources

Telemetrie

Read

Traces

Jaeger logo

Jaeger

Service-Abhängigkeiten · Span-Analyse

Workflow

Read + scoped w

Incident-Management

Atlassian Jira logo

Atlassian Jira

Issues · Kommentare · CRUD

ServiceNow logo

ServiceNow

Incidents · Kommentare

PagerDuty logo

PagerDuty

Incidents · On-Call · Ack/Resolve

ilert logo

ilert

Alerts · On-call · Escalations · Status pages

Intelligenz

Austauschbar

Model-Anbieter

Azure OpenAI logo

Azure OpenAI

GPT-5-Serie

Anthropic Claude logo

Anthropic Claude

Claude 5 · Sonnet · Haiku

Google Gemini logo

Google Gemini

Vertex AI · Gemini-3-Serie

AWS Bedrock logo

AWS Bedrock

Modell-Gateway für mehrere Anbieter

OpenAI logo

OpenAI

GPT-5 series · Direct API

Azure AI Foundry logo

Azure AI Foundry

Azure-hosted deployments

OpenAI-compatible endpoints logo

OpenAI-compatible endpoints

vLLM · Scaleway · Together · Fireworks

LiteLLM logo

LiteLLM

100+ Anbieter · einheitliches Gateway

Wissen

Read

Dokumentation

Confluence logo

Confluence

Spaces · CQL

Git repositories logo

Git-Repositories

Shallow Clone · PAT

Artifactory logo

Artifactory

Repo-Key

File upload logo

Datei-Upload

PDF · DOCX · MD

Dienstprogramme

Austauschbar

Extensibility

WebFetch logo

WebFetch

URL-Abruf · HTML zu Markdown · Allowlist

Custom API logo

Custom API

Your HTTP APIs · Method and path rules

Custom MCP logo

Custom MCP

Your MCP servers · In-cluster

Orchestrierung

RBAC

Kubernetes

Cluster API logo

Cluster API

Vollständige API

Custom CRDs logo

Custom CRDs

Argo CD · Prometheus · Traefik · usw.

Telemetrie

Read

Logs

Loki logo

Loki

LogQL · Label-Discovery

OpenSearch logo

OpenSearch

Query-DSL · Field-Mapping

Elasticsearch logo

Elasticsearch

SQL · Index-Patterns

Graylog logo

Graylog

Streams · Suche

Splunk logo

Splunk

SPL · Indizes · gespeicherte Suchen

Telemetrie

Read

Metriken

Prometheus logo

Prometheus

PromQL · pro Instanz getrennt

InfluxDB logo

InfluxDB

Flux · Zeitreihen

Nagios logo

Nagios

Host-/Service-Status · Thruk-UI

Source & Issues

Read + scoped w

Versionskontrolle

GitHub logo

GitHub

PRs · Issues · Kommentare · Code

GitLab logo

GitLab

MRs · Pipelines · Repos

Streaming

Read

Messaging

RabbitMQ logo

RabbitMQ

Queues · Exchanges · Consumers

Amazon Web Services logo

Apache Kafka

Topics · Consumer groups · Partitions · Broker health & config

Speicherung

Read

Datenbanken

PostgreSQL logo

PostgreSQL

Relational · Leserolle

MongoDB logo

MongoDB

Dokumente · Lesebenutzer

Redis logo

Redis

Key-Value · Lesebefehle

ClickHouse logo

ClickHouse

Spaltenorientiert · Leserolle

MySQL logo

MySQL

Relational · Read account · Multi-DB

Oracle logo

Oracle

SQL*Plus · Read account · Multi-DB

Kommunikation

Read + scoped w

Benachrichtigungen

Email logo

E-Mail

MS Graph · IMAP/SMTP

Slack logo

Slack

Webhooks · AutoRCA-Zustellung

Microsoft Teams logo

Microsoft Teams

Webhooks · Channel-Posts

Cloud

Cloud-Plattformen

Amazon Web Services logo

Amazon Web Services

Microsoft Azure logo

Microsoft Azure

Google Cloud logo

Google Cloud

Read

Delivery

GitOps

Argo CD logo

Argo CD

Flux CD logo

Flux CD

Read

Telemetrie

Traces

Jaeger logo

Jaeger

Read

Workflow

Incident-Management

Atlassian Jira logo

Atlassian Jira

ServiceNow logo

ServiceNow

PagerDuty logo

PagerDuty

ilert logo

ilert

Read + scoped w

Intelligenz

Model-Anbieter

Azure OpenAI logo

Azure OpenAI

Anthropic Claude logo

Anthropic Claude

Google Gemini logo

Google Gemini

AWS Bedrock logo

AWS Bedrock

OpenAI logo

OpenAI

Azure AI Foundry logo

Azure AI Foundry

OpenAI-compatible endpoints logo

OpenAI-compatible endpoints

LiteLLM logo

LiteLLM

Austauschbar

Wissen

Dokumentation

Confluence logo

Confluence

Git repositories logo

Git-Repositories

Artifactory logo

Artifactory

File upload logo

Datei-Upload

Read

Dienstprogramme

Extensibility

WebFetch logo

WebFetch

Custom API logo

Custom API

Custom MCP logo

Custom MCP

Austauschbar

Orchestrierung

Kubernetes

Cluster API logo

Cluster API

Custom CRDs logo

Custom CRDs

RBAC

Telemetrie

Logs

Loki logo

Loki

OpenSearch logo

OpenSearch

Elasticsearch logo

Elasticsearch

Graylog logo

Graylog

Splunk logo

Splunk

Read

Telemetrie

Metriken

Prometheus logo

Prometheus

InfluxDB logo

InfluxDB

Nagios logo

Nagios

Read

Source & Issues

Versionskontrolle

GitHub logo

GitHub

GitLab logo

GitLab

Read + scoped w

Streaming

Messaging

RabbitMQ logo

RabbitMQ

Amazon Web Services logo

Apache Kafka

Read

Speicherung

Datenbanken

PostgreSQL logo

PostgreSQL

MongoDB logo

MongoDB

Redis logo

Redis

ClickHouse logo

ClickHouse

MySQL logo

MySQL

Oracle logo

Oracle

Read

Kommunikation

Benachrichtigungen

Email logo

E-Mail

Slack logo

Slack

Microsoft Teams logo

Microsoft Teams

Read + scoped w

Painterly illustration of an eagle in flight silhouetted against a golden sunset over snow-capped mountains
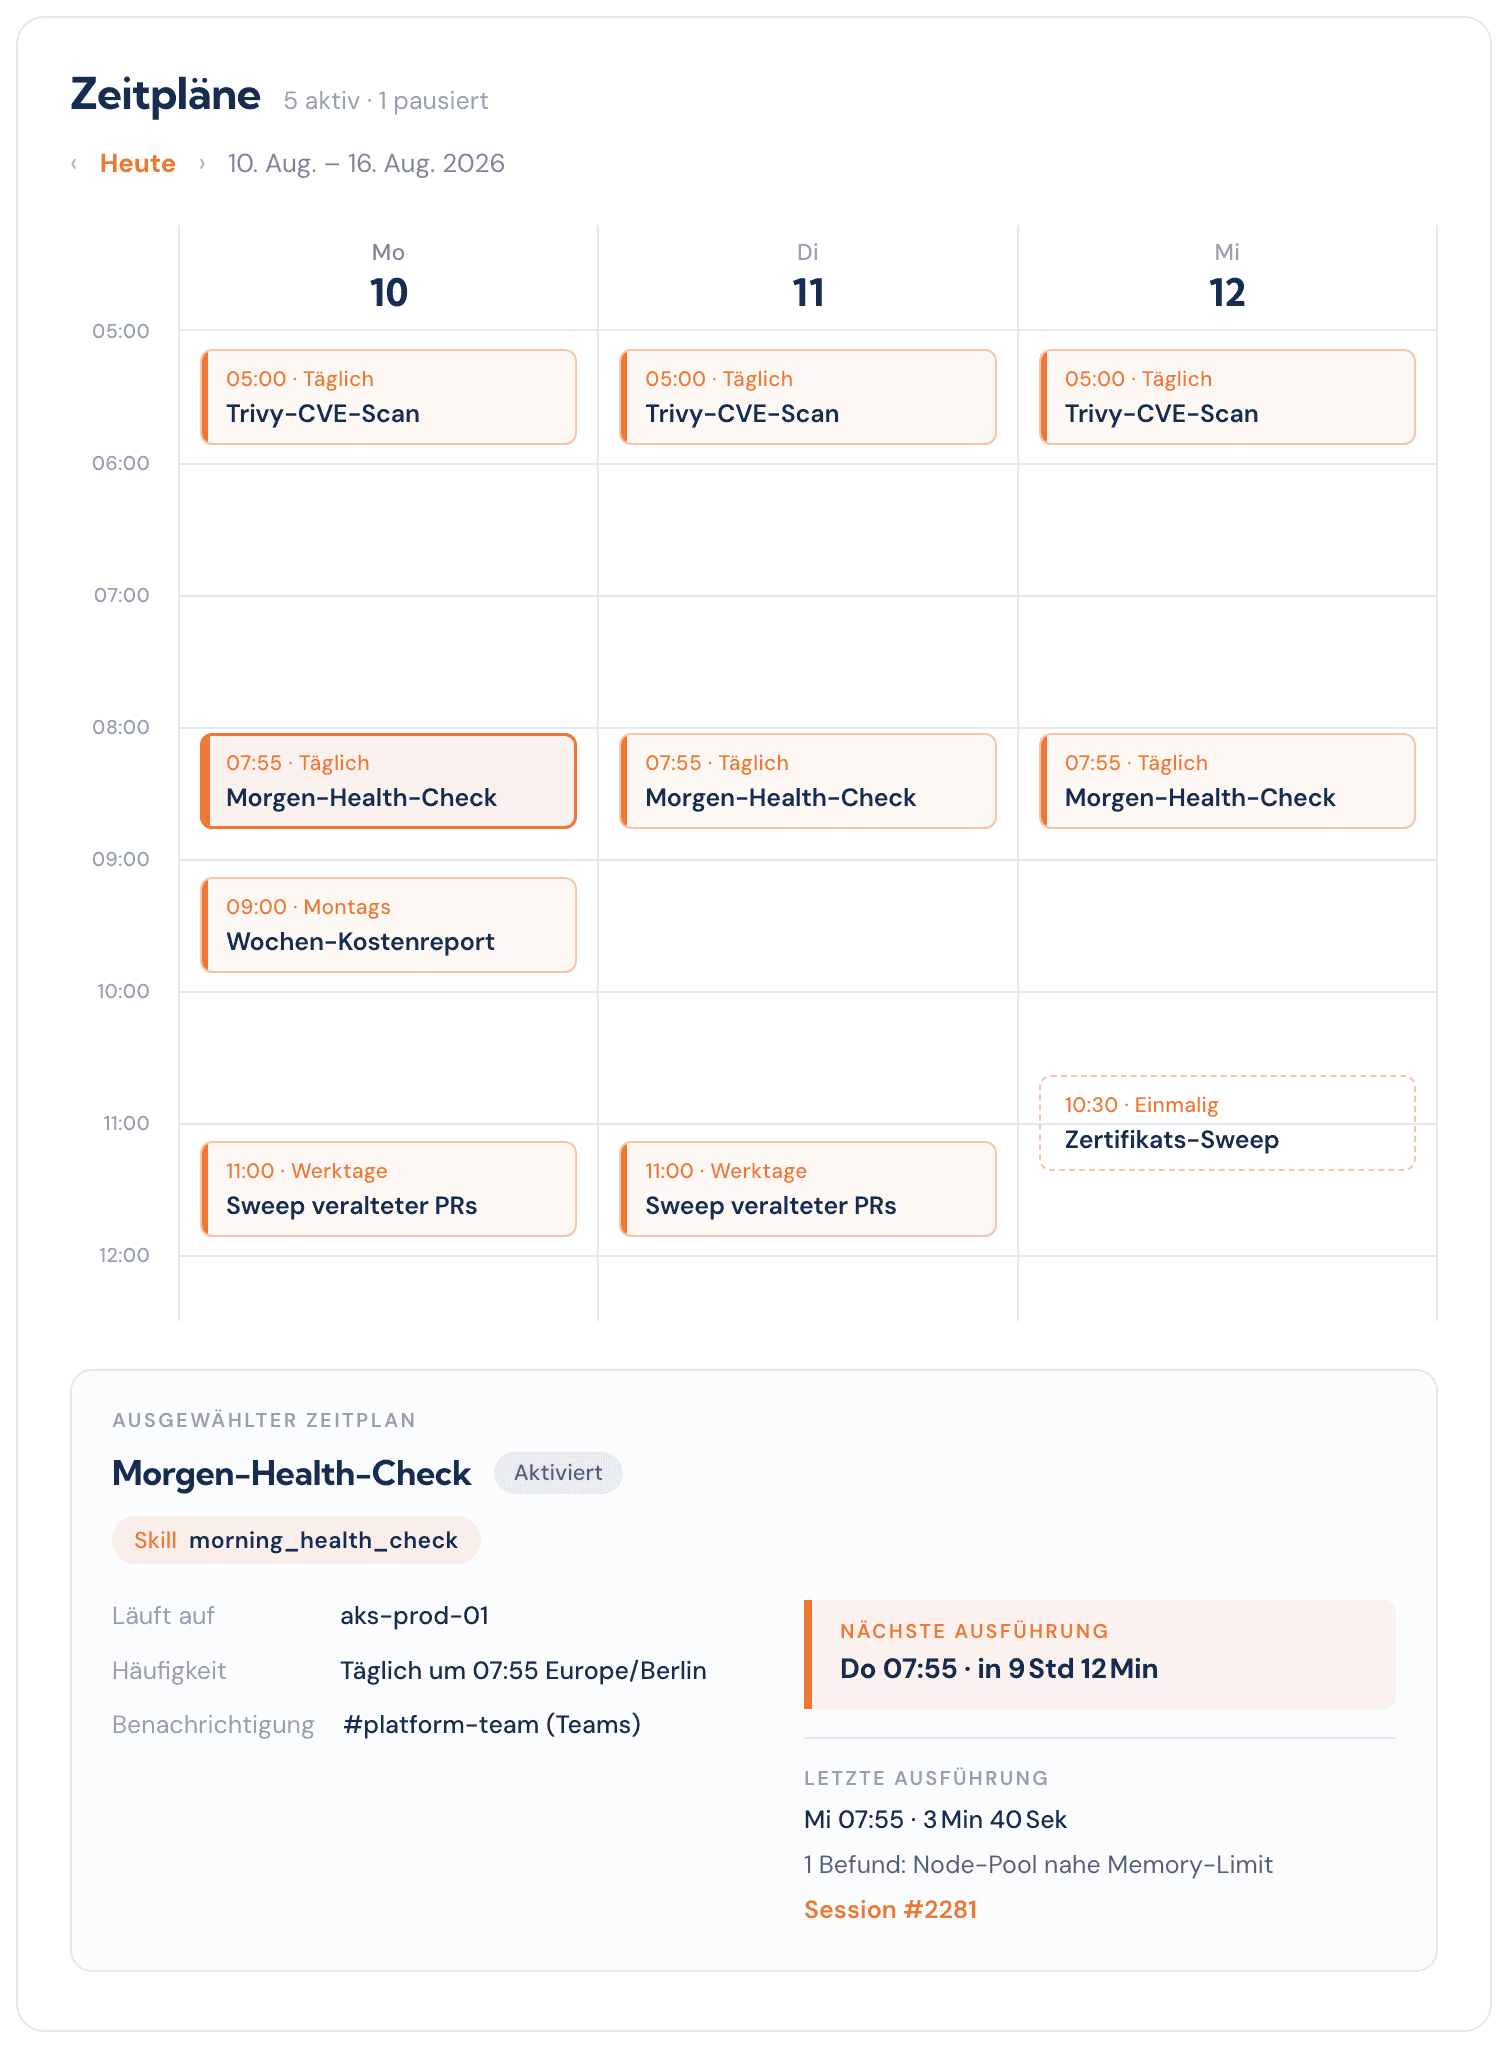
Screenshot of the Hyground app's Schedules view, showing a calendar of recurring automated checks like CVE scans and health checks
Painterly illustration of an eagle in flight silhouetted against a golden sunset over snow-capped mountains
Screenshot of the Hyground app's Schedules view, showing a calendar of recurring automated checks like CVE scans and health checks

SKILLS & ZEITPLÄNE

Gelöste Probleme bleiben gelöst.

Gelöste Probleme werden zu Skills, die bei jedem Lauf dieselben Schritte durchlaufen. Die Checkliste der erfahrensten Engineers überdauert damit die Engineers.

Wählen Sie einen Anwendungsfall aus der Vorlagenbibliothek. Hyground gleicht ihn mit Ihrer Umgebung ab und schreibt den Skill dann gemeinsam mit Ihnen.

Führen Sie Skills nach Zeitplan aus: z.B. Kostenreport montags, CVE-Triage nachts.

Das Team bekommt einen auditierten Agenten, nicht fünf private mit Zugangsdaten zur Produktionsumgebung.

Standardsupport

Das Setup ist ein Helm-Chart.
Den Rest gehen wir gemeinsam an.

Installiert mit einem Helm-Chart.
Den Rest gehen wir gemeinsam an.

Das Setup ist ein Helm-Chart. Den Rest gehen wir gemeinsam an.

Ein Forward Deployed Engineer arbeitet von der Installation bis zum täglichen Einsatz im Team mit: Stack anbinden, Modell wählen, Schulung durchführen, erste Workflows bauen. Hier drückt Ihnen niemand einen Login in die Hand und lässt Sie allein.

Woche 1

GEMEINSAM

Kickoff

Bevor irgendetwas installiert wird, definieren wir gemeinsam Use Cases und, was Erfolg in Zahlen heißt.

Woche 2

HYGROUND

Installation

Ein Helm-Chart kommt in den eigenen Cluster. Unsere Engineers binden Telemetrie, Observability-Daten, Dokumentation, Git-Repositories und weitere Quellen an. Danach verbinden sie Hyground mit Ihrem LLM-Endpoint.

Woche 3

HYGROUND

Go-live und Schulung

Wir schulen praxisnah. Danach setzt das Pilotteam Hyground im Tagesbetrieb ein. Die ersten Workflows bauen wir gemeinsam.

Woche 6

GEMEINSAM

Ergebnisse

Gemessen wird an den Kriterien aus Woche eins, nicht an Momentaufnahmen. Dann entscheiden Sie.

Der Support endet nicht mit dem Go-live.

Nach der Pilotphase betreut der zugewiesene Engineer den Account weiter.

Dieselben Engineers
Die gleichen Engineers

Sie sprechen direkt mit den Leuten, die Hyground bauen: bei Fragen, bei Konfigurationsänderungen und bei allem, was kaputtgeht. Eine Ticket-Warteschlange gibt es nicht.

Sie sprechen direkt mit den Leuten, die Hyground bauen: bei Fragen, bei Konfigurations-änderungen und bei allem, was kaputtgeht. Eine Ticket-Warteschlange gibt es nicht.

Wir bauen gemeinsam weiter
Wir entwickeln gemeinsam weiter

Neue Adapter, neue Datenquellen, neue Workflows bauen wir Seite an Seite mit dem Team, während sich Stack und Modelle verändern.

Vorteile

Läuft in kritischer Infrastruktur, im Produktivbetrieb.

Läuft in kritischer Infrastruktur, im Produktivbetrieb bewährt.

Diese Kennzahlen stammen aus echten Deployments bei DACH-Betreibern kritischer Infrastruktur im Produktivbetrieb.

<5 min

<5 min

<5 min

Root-Cause Analyse mit Hyground

Jeder Incident wird analysiert bevor es ein Business-Event wird und jeder On-Call Engineer ist mit einem Experten ausgestattet.

100%

100%

100 %

Daten-Souveränität

85 %

85 %

85 %

schnellere MTTR


-60%

-60%

-60 %

reduzierter manueller Toil

Geprüft

Geprüft

ISO/IEC 27001

ISO/IEC 27001

Unabhängig zertifiziertes Informationssicherheits-Management

Unabhängig zertifiziertes Informationssicherheits-Management

5-10 Std.

5-10 Std.

5-10 Std.

Zeitersparnis pro Engineer pro Woche

Hyground verknüpft sich mit Ihrem gesamten System und ist in der Lage, Dokumentation, Code und Telemetrie quer zu referenzieren.

FAQ

Häufige Fragen

Worin unterscheidet sich ein KI-SRE-Agent von anderen AIOps-Plattformen?

Hyground unterscheidet sich von klassischen AIOps-Plattformen darin, dass es den Observability-Stack ausliest, den Sie bereits betreiben, und dabei so vorgeht, wie es ein erfahrenes Engineering-Team tun würde. LLM-Foundation-Models auf dem aktuellen Stand der Technik bilden Hypothesen und prüfen sie gegen Logs, Metriken, Traces, die Deployment-Historie und die eigenen Runbooks. Klassische AIOps-Plattformen gehen den umgekehrten Weg: Sie ziehen die Telemetriedaten in einen eigenen Speicher, korrelieren sie dort und liefern am Ende ein Dashboard oder eine Ansammlung von Alerts. Hyground liefert stattdessen eine priorisierte Liste wahrscheinlicher Ursachen, jede verknüpft mit Belegen.

Setzt Hyground Kubernetes voraus?

Yes. Hyground deploys as a Helm chart into a conformant Kubernetes cluster running 1.27 or later. AKS, EKS, GKE, OpenShift, K3s and on-premises distributions all work. But Kubernetes is only where Hyground runs, not the limit of what it can see. It also investigates the infrastructure around the cluster: virtual machines, cloud services, databases and anything else you connect it to.
Müssen wir unseren Observability-Stack ersetzen?

Nein. Hyground liest den Observability-Stack aus, den Sie bereits betreiben, statt ihn durch ein Hersteller-Backend zu ersetzen. Wir ergänzen laufend neue Adapter und decken Kubernetes, Prometheus, Loki, Elasticsearch und die übrigen Werkzeuge ab, mit denen Ihr Team ohnehin arbeitet. Alles, was einen Webhook senden kann, kann zudem eine Untersuchung auslösen, darunter Alertmanager, Grafana, Datadog und PagerDuty. Die vollständige Liste finden Sie auf unserer Integrationsseite. Fehlt etwas aus Ihrem Stack, liefern unsere Engineers gemeinsam mit Ihnen die nötigen Konnektoren nach.

Welche Daten verlassen unsere Infrastruktur, wenn Hyground eine Untersuchung durchführt?

Hyground sendet keine Daten an uns oder ins Internet, alles bleibt innerhalb Ihres Perimeters. Wir erhalten, speichern oder vermitteln Ihre Betriebsdaten zu keinem Zeitpunkt, und dass der Agent keine Verbindung nach außen aufbaut, lässt sich in den eigenen Netzwerk-Policies und Egress-Logs nachprüfen. Mit einem selbst gehosteten LLM verlassen keine Betriebsdaten die eigene Infrastruktur. Mit einem in der Cloud gehosteten Modell erreichen Ihre Prompts den Anbieter, den Sie gewählt haben, aber niemals Hyground.

Welches LLM nutzt Hyground?

Hyground ist von Grund auf modellunabhängig. Der Agent lässt sich mit jedem Endpoint verbinden, der das branchenübliche OpenAI-kompatible API-Format spricht, auch mit selbst gehosteten Modellen. Nicht jedes Modell liefert dabei dieselbe Qualität, deshalb pflegen wir eine laufend aktualisierte Liste empfohlener LLMs, die wir intern evaluieren und nach Lösungsquote, Effizienz der Tool-Aufrufe, Token-Verbrauch, Geschwindigkeit und faktischer Fundierung bewerten.

Wie verhält sich Hyground zur DSGVO?

Hyground ist von Grund auf für DSGVO-Compliance gebaut. Der Agent läuft vollständig innerhalb Ihres eigenen Perimeters: Betriebsdaten bleiben in einer Infrastruktur, die ohnehin unter Ihrer Kontrolle steht, es gibt keine Übermittlung an einen von Hyground betriebenen Dienst, und jede Aktion wird protokolliert und ist auditierbar.

Um wie viel senkt Hyground die MTTR?

Kunden haben Incident-Behebungszeiten um bis zu 85% sinken sehen, gemessen im laufenden Produktivbetrieb. Hyground startet die Untersuchung in dem Moment, in dem der Alert auslöst. Bis jemand am Laptop sitzt, ist die Korrelationsarbeit erledigt, und es liegen priorisierte wahrscheinliche Ursachen samt der Belege dazu vor. Ihr eigener Wert hängt davon ab, wie sich Ihre Incidents zusammensetzen und wie viel von Ihrem Stack Hyground auslesen kann.

Wie lange dauert die Einführung von Hyground?

Das Setup selbst ist ein Helm-Chart-Deployment und läuft innerhalb von 30 Minuten. Anschließend konfigurieren unsere Engineers gemeinsam mit Ihrem Team die Adapter, wählen ein passendes Modell aus und binden Ihren Stack an, damit der Agent den vollständigen Kontext Ihrer Systeme hat. Wie lange das dauert, hängt von Ihrer Infrastruktur ab. Die meisten Unternehmen sind innerhalb von zwei Wochen nach Vertragsabschluss vollständig produktiv.

Wie ist das Preismodell aufgebaut?

Hyground wird als jährliche Pauschallizenz abgerechnet, gestaffelt nach der Größe Ihrer Infrastruktur. Es gibt keine Kosten pro Nutzer, keine Credits pro Untersuchung und keine nutzungsabhängige Abrechnung, ein Anstieg des Incident-Volumens ändert die Rechnung also nicht. Die LLM-Token zahlen Sie direkt an Ihren Modellanbieter, unter Ihrem eigenen Vertrag. Das hält diese Kosten sichtbar und steuerbar, statt sie mit Aufschlag in einer Plattformgebühr verschwinden zu lassen.

Bietet Hyground laufenden Support?

Sie behalten denselben direkten Draht zum Engineering-Team, für Fragen, Konfigurationsänderungen und alles, was ausfällt. Der Support läuft montags bis freitags von 8:00 bis 18:00 Uhr MEZ, außer an bundeseinheitlichen Feiertagen.

Hyground live erleben